GTC | 로컬 AI 하드웨어 전체 제품군 선보인다, 엔비디아 유럽서 로컬 인텔리전스로 차세대 에이전트 지원
엔비디아(www.nvidia.co.kr)가 이번 주 독일 베를린에서 진행되는 ‘GTC 베를린(GTC Berlin)’에서 로컬 AI 하드웨어 전체 제품군을 선보인다고 밝혔다.
지난주 출시된 RTX 스파크(RTX Spark)는 윈도우(Windows) PC에서 개인용 에이전트를 구동하며, DGX 스파크(DGX Spark)는 리눅스(Linux) 환경 애플리케이션 개발·확장을 지원한다. DGX 스테이션(DGX Station)은 리눅스에서 고급 워크로드를 실행하는 기업 조직을 위한 제품으로, 윈도우 버전은 12월 출시될 예정이다.
발표 내용은 다음과 같다.
RTX 스파크에서 언더독 데스크톱 에이전트(Underdog Desktop Agent) 사용 가능
DGX 스파크 64GB 모델 10월 23일(현지 시간) 출시
이달 엔비디아 싱크(NVIDIA Sync) DGX 스파크 8대 연결 지원 및 모델 런처(Model Launcher) 추가
10월 DGX 스파크 소프트웨어 업데이트로 와이파이 어시스턴트(Wi-Fi Assistant) 추가, DGX 스파크 스킬(Skills) 업데이트
DGX 스테이션, 7가지 신규 통합 기능으로 관리 편의성 향상
DGX 스테이션 윈도우 버전 12월 출시, 다양한 제조 애플리케이션과 에이전트 하네스 지원
DGX 스테이션 로보틱스 오픈소스 참조 워크플로우 3종 공개
DGX 스테이션에서 엔비디아 클라우드 펑션(Cloud Functions) 얼리 액세스 제공 예정
엔비디아 로컬 하드웨어에서 사용할 수 있는 신규 로컬 코딩 모델인 리커시브 플린트(Recursive Flint) 출시
네모트론(Nemotron), GLM, 딥시크(DeepSeek), 큐원(Qwen), 미니맥스(MiniMax), 플럭스.3(FLUX.3) AI 모델 기본 지원
라마.cpp(llama.cpp)와 vLLM 추론 엔진 가속 기능과 로컬 AI 하드웨어에 최적화된 신규 모델 체크포인트 모음 공개
GTC 베를린에서 진행되는 데모와 세션은 여기에서 살펴볼 수 있다.
RTX 스파크, 윈도우 PC에 개인용 에이전트 구현
RTX 스파크는 PC의 새로운 시작이다. 최대 128GB의 통합 메모리와 1페타플롭의 AI 컴퓨팅 성능을 바탕으로 개인용 에이전트 실행, 콘텐츠 제작 가속, 1440p 100 FPS 게이밍을 지원한다.
지난 10월 16일(현지 시간) 정식 출시 이후 초기 리뷰어들은 RTX 스파크에 대해 긍정적인 평가를 내놨다. CG매그(CGMag)는 “진지하게 창작 활동을 하는 사람들을 위한 꿈의 기기”라고 평가했으며, 더 버지(The Verge)는 “AI의 미래를 위해 설계된 제품”이라고 말했다. PC매그(PCMag)는 “놀라울 정도로 휴대성과 효율성이 뛰어나면서도 매우 강력한 기기”라고 평가했다.
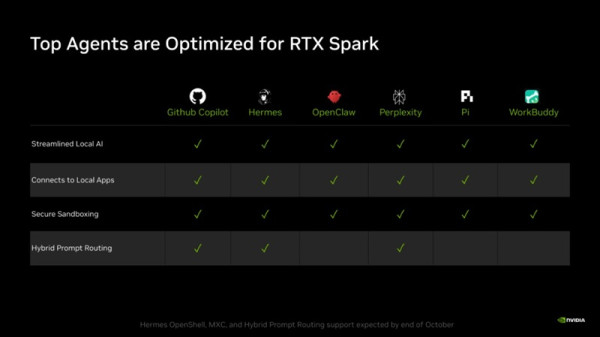
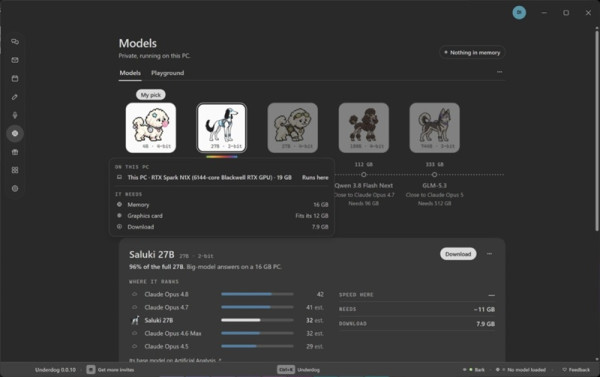
기기 내에서 AI를 완전히 실행하고 개인정보를 보호하도록 설계된 새로운 데스크톱 에이전트 앱 언더독도 RTX 스파크에서 사용할 수 있다. 언더독은 모델별로 특화된 추론 엔진인 허스키(Husky)를 기반으로 모델을 기기 내에서 완전히 실행한다. 따라서 개인용 에이전트가 사용자 데이터를 PC 외부로 전송하지 않고도 작업을 수행할 수 있다. 언더독은 현재 다운로드할 수 있다.
다수 RTX 스파크 노트북에는 잠금 해제된 부트로더가 탑재되며, 개발자와 기술 애호가는 로컬 에이전트를 더욱 쉽게 개발하고 맞춤 설정할 수 있다.
GTC 기조연설에서 엔비디아 창립자 겸 CEO 젠슨 황(Jensen Huang)은 RTX 스파크에서 실행되는 AI 에이전트를 활용해 허깅페이스(Hugging Face)의 마이크로덕(Microduck) 로봇 훈련을 시연했다. 이 시연에는 엔비디아 아이작 랩(Isaac Lab), 헤르메스 에이전트(Hermes Agent), 네모트론 3.5 볼트 74B(Nemotron 3.5 Bolt 74B)가 사용됐다.
에이수스(ASUS), 델 테크놀로지스(Dell Technologies), HP, 레노버(Lenovo), 마이크로소프트(Microsoft), MSI 노트북은 현재 판매 중이며, 에이서(Acer) 제품도 곧 출시될 예정이다.
여기에서 RTX 스파크에 대해 자세히 알아볼 수 있으며, 최신 RTX 스파크 플레이북은 여기에서 확인할 수 있다.
DGX 스파크, 개발자에게 더 넓은 개발 환경 제공
네모트론 3.5 볼트 74B 24GB, 큐원3.8 27B, 젬마 4 26B-A4B(Gemma 4 26B-A4B) 등의 모델을 실행할 수 있는 새로운 DGX 스파크 64GB 시스템이 10월 23일(현지 시간)부터 파트너사를 통해 출시된다.
워크로드에 더 큰 용량이 필요한 경우 개발자는 내장된 엔비디아 커넥트X-7(ConnectX-7) 네트워킹과 엔비디아 싱크 클러스터 어시스턴트(Sync Cluster Assistant)를 통해 여러 DGX 스파크 시스템을 연결할 수 있다. 이를 통해 큐원 3.8 플래시 넥스트(Qwen 3.8 Flash Next), 딥시크 v4 플래시 0731(DeepSeek v4 Flash 0731), GLM 5.3 플래시(GLM 5.3 Flash)와 같은 고급 코딩 모델을 실행할 수 있다.
이제 DGX 스파크는 수동 구성 방식으로 최대 8대의 클러스터를 지원한다. 더 큰 모델과 긴 컨텍스트, 동시 실행 에이전트, 분산 개발을 지원하며, 하나의 클러스터를 백엔드로 공유하는 소규모 조직에 적합하다. 각 개발자는 동일한 모델을 대상으로 여러 세션을 동시에 실행할 수 있다. 또한 GLM 5.3과 같은 프론티어 모델을 실행하기에 충분한 1TB 통합 메모리를 제공한다.
DGX 스파크 클러스터 플레이북을 참고해 시작할 수 있다.
엔비디아 싱크 모델 런처(Sync Model Launcher)는 이달 말 제공될 예정이다. 이 기능은 단일 DGX 스파크 또는 클러스터에서 로컬 AI 접근을 더욱 쉽게 만든다. 몇 번의 클릭만으로 모델 런처가 시스템 구성에 적합한 모델과 컨테이너를 다운로드하고, 해당 모델을 오픈코드(OpenCode)에 연결한다. 또한 문제 해결, 기기 유지 관리, 공식 문서 접근, 기타 워크플로우 안내를 위해 DGX 스파크 스킬을 자동으로 불러온다.
10월 DGX 스파크 소프트웨어 업데이트에는 DGX 스파크가 어플라이언스 모드(appliance mode)로 실행 중일 때 사용자가 네트워크를 전환할 수 있도록 하는 새로운 와이파이 어시스턴트가 포함된다. 또한 DGX 스파크 스킬은 오픈코드를 통해 엔비디아 싱크에 직접 통합되며, 문제 해결과 기기 유지 관리에 필요한 워크플로우 중심의 안내를 제공한다.
DGX 스파크 시스템은 에이서, 에이수스, 델 테크놀로지스, 기가바이트(GIGABYTE), HP, 레노버, MSI, 엔비디아에서 직접 구매할 수 있다.
DGX 스테이션, 데스크톱에서 프론티어 인텔리전스 구현
DGX 스테이션은 대규모 조직을 위해 748GB의 코히어런트 메모리(coherent memory)와 최대 20페타플롭의 AI 성능을 제공한다. 개발자는 GLM 5.3과 같은 고급 모델을 실행하고, 클라우드 모델에 필적하는 속도로 30명 이상의 사용자에게 서비스를 제공할 수 있다. 이제 엔비디아 싱크는 DGX 스테이션 지원으로 확장성을 높이며, 두 대의 리눅스 기반 시스템을 간편하게 연결한다.
앱솔루트 시큐리티(Absolute Security), 시스코(Cisco)의 스플렁크(Splunk), 플릿 디바이스 매니지먼트(Fleet Device Management), 마이크로소프트 인튠(Intune), 퍼포스 퍼펫(Perforce Puppet), 프로그레스 소프트웨어 셰프(Progress Software Chef), 태니엄(Tanium)과의 새로운 통합 기능을 통해 IT 조직은 기업 환경의 설정, 관리, 규정 준수 프로세스에 따라 DGX 스테이션 시스템을 관리할 수 있다. 승인 절차를 앞당기고 배포 위험을 줄이는 동시에 첫 토큰 생성까지 걸리는 시간을 최소화할 수 있다.
출시 예정인 윈도우 기반 시스템을 사용하면 개발자는 전문 애플리케이션을 활용하는 워크플로우를 구축하고, 엔비디아 RTX PRO GPU에서 실행하며, 엔비디아 GB300 시스템에서 거대 언어 모델(large language model, LLM)을 구동하는 에이전트를 통해 작업을 수행할 수 있다. 이 모든 기능은 하나의 기기에서 이용 가능하다.
시스템 제조 파트너사를 통해 12월 출시될 예정인 윈도우용 DGX 스테이션(DGX Station for Windows)은 기업이 이미 사용하는 애플리케이션과 운영 환경으로 로컬 AI를 확장한다. 엔지니어는 윈도우 네이티브 소프트웨어에서 로컬 모델과 에이전트를 실행하면서 동일한 시스템의 AI 모델, 도구, 에이전트에 접근할 수 있다.
윈도우용 DGX 스테이션은 AI 기반 설계, 시뮬레이션, 검증, 엔지니어링 자동화를 위해 엔톱(nTop), 다쏘시스템(Dassault Systèmes), 키사이트 테크놀로지스(Keysight Technologies), 매스웍스(MathWorks), 로크웰 오토메이션(Rockwell Automation), 지멘스(Siemens), 시높시스(Synopsys), 유니티(Unity), 알테라(Altera)의 제조 애플리케이션을 지원한다. 사용자는 기업 환경에서 에이전틱 제어를 위해 헤르메스 에이전트, 퍼플렉시티(Perplexity), 에이블(Aible)을 온프레미스에서 실행할 수 있다.
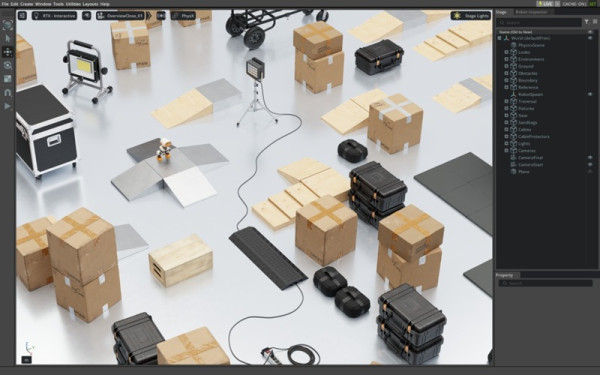
동일한 로컬 기반의 통제된 컴퓨팅 모델은 로보틱스 분야에도 적용된다. DGX 스테이션은 로보틱스 조직에 사후 훈련, 시뮬레이션, 평가를 위한 전용 컴퓨팅 자원을 제공해 공유 인프라를 기다릴 필요 없이 반복 개발 주기를 단축한다.
엔비디아는 GPT-6 아스트라(GPT-6 Astra), 엔비디아 아이작 랩(Isaac Lab), 아이작 랩 아레나(Isaac Lab-Arena), 코스모스(Cosmos)를 엔비디아 DGX 스테이션에서 활용할 수 있도록 오픈소스 참조 워크플로우 3종을 공개했다. 개발자는 이를 활용해 강화 학습으로 GR00T 1.7 모델을 개선하고, 정교한 조작 기술을 훈련하며, 합성 데이터 생성을 위해 코스모스 월드 모델을 사후 훈련할 수 있다.
엔비디아 클라우드 펑션은 리눅스 기반 DGX 스테이션에서 얼리 액세스로 제공될 예정이다. 조직은 공유 카탈로그에 로컬 모델 엔드포인트를 등록하고, 하나의 오픈AI(OpenAI) 호환 진입점을 통해 해당 모델에 접근할 수 있다.
개발자는 애플리케이션 코드를 변경하지 않고도 엔드포인트에서 사용하는 모델을 업그레이드할 수 있으며, 구성원들은 기기에 직접 접근하지 않고도 공유 모델을 이용할 수 있다. 이를 통해 DGX 스테이션을 조직 단위로 제어 가능한 로컬 추론 서비스로 활용할 수 있다.
DGX 스테이션은 AI 팩토리 개발 과정에서 로컬 반복 개발을 지원한다. GTC 베를린 현장에서는 전체 인프라가 구축되기 전에 AI 팩토리 운영을 시뮬레이션할 수 있도록 DGX 스테이션에서 실행되는 DSX OS를 시연한다. 또 다른 데모에서는 30명 이상의 소프트웨어 개발자를 위한 로컬 토큰 팩토리를 구동하는 DGX 스테이션 시스템을 선보인다.
DGX 스테이션 시스템은 현재 에이수스, 델 테크놀로지스, 기가바이트, HP, MSI, 슈퍼마이크로(Supermicro), 익잭트(Exxact)에서 제공된다. 윈도우용 DGX 스테이션 시스템은 올해 말부터 에이수스, 델 테크놀로지스, 기가바이트, HP, MSI, 슈퍼마이크로를 통해 제공될 예정이다.
리커시브 플린트, RTX 스파크에 최적화된 새로운 로컬 코딩 모델
프론티어 AI 연구소 리커시브 슈퍼인텔리전스(Recursive Superintelligence)는 빠르고 정확한 코딩을 위해 설계된 로컬 LLM인 리커시브 플린트를 공개했다. 25억 활성 파라미터를 사용하는 400억 파라미터 전문가 혼합(Mixture-of-Experts, MoE) 모델인 리커시브 플린트는 빠른 추론 성능을 제공한다. 64GB RTX 스파크에서 초당 220토큰을 넘는 속도를 기록했으며, SWE-벤치 프로 v2(SWE-Bench Pro v2), 터미널-벤치 2.1(Terminal-Bench 2.1), SWE-벤치 베리파이드(SWE-bench Verified)와 같은 에이전틱 코딩 벤치마크에서도 동급 최고 수준의 점수를 달성했다.
리커시브 플린트는 리커시브의 대규모 자동 AI 연구 시스템인 유레카 머신(Eureka Machine)을 활용해 구축됐다. 이 시스템은 아이디어 제안, 구현, 아이디어 검증을 위한 실험 실행, 결과를 바탕으로 다음 시도 결정에 이르는 전체 연구 과정을 자동화한다. 이를 통해 모델 가중치를 변경하지 않고도 RTX 스파크에서 플린트(Flint)의 생성 속도를 55% 높이는 특화 커널을 개발했다.
개발자는 허깅 페이스에서 아파치 2.0(Apache 2.0) 라이선스로 개방형 가중치를 다운로드할 수 있다. 해당 모델은 RTX 스파크와 DGX 스파크 시스템, 지포스(GeForce) RTX GPU, RTX PRO GPU에서 실행할 수 있다. 개발자는 또한 네모 오토모델(NeMo Automodel)을 활용해 지도 파인튜닝(supervised fine-tuning)과 로우 랭크 어댑테이션(low-rank adaptation, LoRa)을 수행하거나, 네모 RL(NeMo RL)을 통해 그룹 상대 정책 최적화를 적용해 모델을 사후 훈련시킬 수 있다.
신규 모델 출시 즉시 지원
엔비디아는 네모트론 볼트 E4B 4B, GLM, 딥시크, 큐원, 미니맥스, 리퀴드 AI(Liquid AI) LFM2.5-24B-A2B, 플럭스.3 클라인(FLUX.3 Klein) 디퓨전 모델에 대한 기본 지원을 추가한다.
네모트론 볼트 E4B 4GB는 자연스러운 대화와 멀티턴(multi-turn) 에이전틱 스킬을 최소 4GB 메모리에 담았다. 이를 통해 엔비디아 지포스 RTX GPU, 엔비디아 젯슨(Jetson) 기기, RTX 스파크, DGX 스파크에서 빠른 로컬 음성 어시스턴트, 상호작용형 게임 캐릭터, 임베디드 인터페이스를 구동할 수 있다. 볼트 E4B 4GB는 10월 23일(현지 시간) 출시된다.
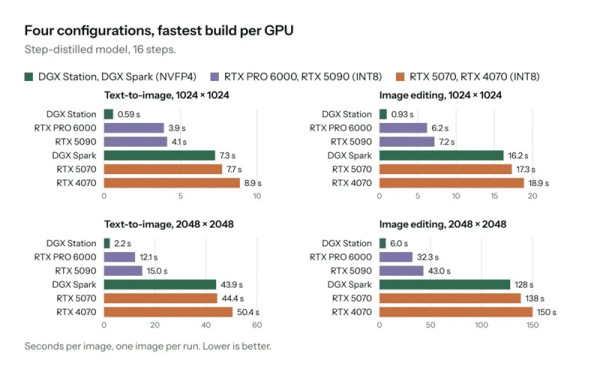
블랙 포레스트 랩스(Black Forest Labs)의 FLUX 3 이미지 클라인(FLUX 3 Image Klein)은 이미지 생성과 편집을 위한 56억 파라미터 오픈 웨이트 이미지 모델이다. 엔비디아 최적화 빌드를 사용하면 VRAM이 8GB에 불과한 지포스 RTX GPU에서도 모델을 실행할 수 있으며, RTX 5090 GPU에서는 약 4초 만에 1메가픽셀 이미지를 생성할 수 있다.
미니맥스 M3.1 플래시는 엔비디아 DGX 스테이션과 DGX 스파크를 위해 설계된 새로운 개방형 모델로, 데스크톱에서 긴 컨텍스트를 처리하는 AI를 제공한다. 리퀴드 AI의 LFM2.5-24B-A2B는 토큰당 240억 파라미터 중 20억 파라미터를 활성화하는 오픈 웨이트 추론 모델이다. 이를 통해 PC에서 도구 호출 AI 에이전트를 빠르고 비공개로 실행할 수 있다.
또한 엔비디아는 로컬 AI 하드웨어에서 RAM 효율성을 높이도록 최적화한 모델 체크포인트 모음을 새롭게 공개했다. 이를 통해 프론티어 개방형 모델을 실행하면서도 KV 캐시를 위한 충분한 메모리를 확보할 수 있다. 각 체크포인트는 전체 정밀도에 가까운 정확도를 유지하도록 양자화됐다. 첫 모델로는 단일 DGX 스파크 128GB 또는 RTX PRO 6000에서 실행할 수 있는 큐원3.8-플래시-넥스트-FP4-로컬(Qwen3.8-Flash-Next-FP4-Local)과 시스템 두 대에서 실행할 수 있는 GLM-5.3-플래시-FP4-로컬(GLM-5.3-Flash-FP4-Local)이 제공된다.
개발자는 DGX 스파크와 RTX 스파크 모두에서 네모 오토모델을 통해 모델 출시 즉시 사후 훈련을 수행할 수 있다. 네모트론 볼트 E4B, 플럭스 3 이미지 클라인 등을 위한 예제 레시피도 제공된다.
AI 추론 가속
엔비디아는 로컬 하드웨어에서 에이전틱 워크로드를 가속하기 위해 라마.cpp와 vLLM 오픈소스 커뮤니티와 지속적으로 협력하고 있다.
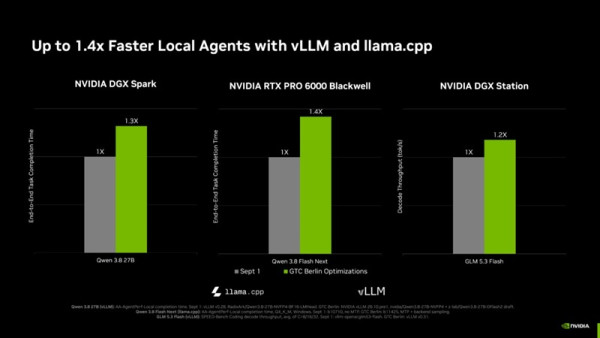
라마.cpp에서는 큐원 3.8 플래시 넥스트를 위한 MTP 기반 추측 디코딩(speculative decoding) 지원이 새롭게 추가됐다. 이를 통해 엔비디아 RTX PRO 6000 블랙웰(Blackwell)에서 엔드투엔드 에이전틱 작업을 최대 1.4배 빠르게 수행할 수 있다.
vLLM에서는 빠른 추측 디코딩과 큐원의 선형 어텐션 계층을 위한 새로운 플래시인퍼(FlashInfer) 프리필 커널을 통해 DGX 스파크에서 큐원3.8 27B를 사용하는 에이전틱 작업의 속도를 최대 1.3배 높일 수 있다. DGX 스테이션에서는 GLM 5.3 플래시의 처리량이 최대 1.2배 향상된다.
엔비디아의 로컬 AI 추론 레시피를 확인하고 최신 최적화를 직접 활용할 수 있다.
X, 인스타그램(Instagram), 틱톡(TikTok), 페이스북(Facebook)에서 엔비디아 RTX 스파크를 팔로우하고 엔비디아 로컬 AI 뉴스레터를 구독해 최신 소식을 받아볼 수 있다. 또한 링크드인(LinkedIn)과 X에서 엔비디아 워크스테이션을 팔로우할 수 있다.
여기에서 소프트웨어 제품 정보 약관을 확인할 수 있다.
엔비디아, NVIDIA, GTC, 2026, GTC 베를린, GTC Berlin, 로컬 AI.하드웨어.전체.제품군.선보인다.유럽서.로컬.인텔리전스로.차세대.에이전트.지원.