IT | 엔비디아 베라 루빈·그록 3 LPX, 전력당 토큰 처리량 향상
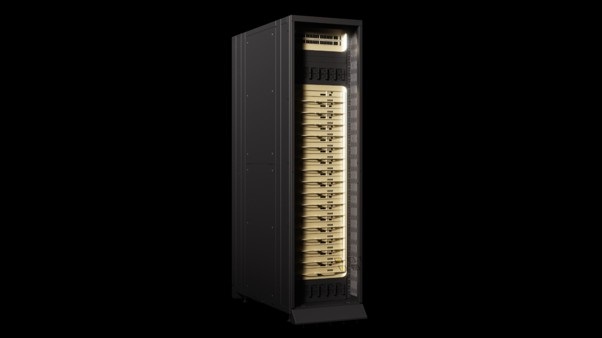
엔비디아(www.nvidia.co.kr)가 엔비디아 베라 루빈(Vera Rubin) NVL72와 그록 3 LPX(Groq 3 LPX)를 기반으로 AI 팩토리의 전력 효율을 높이고, 더 많은 토큰을 처리할 수 있도록 지원한다고 밝혔다.
AI 팩토리에서는 전력이 핵심 제약 요소다. 모든 와트가 중요한 만큼, AI 인프라에서 동일한 메가와트의 전력으로 얼마나 더 많은 토큰을 처리할 수 있는지가 중요하다.
엔비디아는 베라 루빈 NVL72를 기반으로 시스템, 네트워킹, 소프트웨어, 전력 관리를 하나로 통합한 풀스택 AI 팩토리를 통해 이러한 과제에 대응한다. 엔비디아 DSX MaxLPS는 AI 팩토리의 전력 수요 변화에 따라 랙 간 전력을 동적으로 재분배한다.
이를 통해 다음과 같은 상당한 효과를 제공할 수 있다.
l 동일한 시설 전력 용량 내에서 GPU 용량 최대 40% 확대
l 신규 전력선 증설 없이 토큰 처리량 최대 35% 향상
각 랙 내부에서는 지능형 전력 평활화(Intelligent Power Smoothing) 소프트웨어와 확장된 에너지 버퍼링 기능이 순간적인 전력 급증을 흡수해, 시스템이 지속적인 전력 수요에 보다 가깝게 운영될 수 있도록 한다. 이를 통해 기존에 여유 용량으로 남아 있던 전력을 실제 컴퓨팅 자원으로 활용할 수 있다.
에이전틱 AI에서는 에이전트가 여러 단계의 추론과 도구 호출을 연속으로 수행하기 때문에 지연 시간과 컨텍스트 길이에 따른 부담이 빠르게 커질 수 있다. 엔비디아 그록 3 LPX는 베라 루빈에 결정론적 초저지연 추론 기능을 추가하고 DSX MaxLPS를 보완한다. 이 통합 플랫폼은 긴 컨텍스트 환경에서 2조 개 이상의 파라미터를 갖춘 모델을 기준으로 GB200 NVL72 대비 메가와트당 토큰 처리량을 최대 35배까지 높일 수 있다.
성능 수치에서도 이러한 효과가 확인됐다. 10만 토큰 컨텍스트 규모의 큐웬(Qwen) 3.8 27B 워크로드에서 그록 3 LPX는 사용자당 초당 2,529개의 출력 토큰을 기록했다. 이러한 성능 여유를 통해 워크로드가 확장되더라도 에이전트는 동일한 응답 처리 범위 내에서 더 많은 추론 단계와 도구 호출을 수행할 수 있다.
여기서 엔비디아 베라 루빈 NVL72와 그록 3 LPX가 더 적은 전력으로 더 많은 토큰을 생성하는 방법에 대한 자세한 내용을 확인할 수 있다.
엔비디아 베라 루빈, Vera Rubin, 그록 3 LPX, Groq 3 LPX, 전력당, 토큰, 처리량, 향상